
Здравствуйте. Еще в 2024 году я загорелся идеей разработать систему поиска по Telegram, которая позволила бы любому пользователю очень легко и просто находить нужные сведения. Так легко, как это работает сейчас в крупных поисковых системах.
Мои личные поиски часто касается сферы информационной безопасности. Проблема в том, что в обычном интернете таких данных крайне мало. Например, я регулярно занимаюсь поиском прошивок для коммутаторов и роутеров для виртуализации сетей. в открытом доступе их практически нет, однако внутри Telegram среди энтузиастов они активно циркулируют.
Сегодня я расскажу как что я делал и смог ли вообще добиться своих целей спустя 2 года
Первоначальная задумка
Наверняка у многих бывают случаи, когда вы хотите что-то найти, но обычный Яндекс или Гугл не подходят для этого. Какие-нибудь рекомендации, новости, информацию которая в основном бывает только в телеграм (не запрещенная конечно, такое осуждаю). Нужно как то организовать все эти миллиарды постов с каналов на десятки терабайт чтобы сделать по ним удобный поиск.
Сначала всё кажется простым: создаешь базу Postgres и делаешь по ней поиск. Он ищет просто слова из запроса в постах. Если они есть и находятся близко друг к другу, то пост появляется в результатах.
Более продвинутая версия такого типа поиска использует алгоритм BM25 (алгоритм ранжирования).
BM25 (Best Match 25), это популярный алгоритм, который используют для оценки того, насколько точно найденный документ (в нашем случае пост) соответствует запросу пользователя. Он смотрит не только на то, есть ли нужные слова в документе, но и на то, насколько они там действительно важны. То есть он решает простую проблему: чтобы в результатах выше оказывались не самые длинные тексты и не те, где одно и то же слово просто напихано много раз, а те, где ответ на запрос реально ближе и полезнее.
Да, так можно сделать. Так устроен поиск и в Telegram, и в Lolz, да и почти везде. Это легко, быстро и надежно.
Но тут есть 2 проблемы.
1. Поиск не понимает контекст. Он не понимает, что кран, из которого течет вода, и кран, который поднимает грузы это разные вещи. Поэтому в результатах (особенно при абстрактных запросах) может получиться салат из постов, которые вообще не имеют отношения к тому что мы хотим найти.
2. Составление запросов становится адом. К примеру, я хочу найти, где скачать какую-нибудь старую игру-новеллу. Обычный пользователь привык писать в поиске: *«скачать новеллу ... бесплатно»*. Для обычных поисковиков вроде Яндекса и Google это нормальный запрос, но для нашего текущего поиска он не подходит. Если в тексте поста не окажется слов «бесплатно», «скачать» или «игра», то пост просто отбракуется и не попадет в результаты. Но если не писать «бесплатно», в выдачу полезут каналы, где игру предлагают купить.
В итоге сейчас большинство поисковиков по Telegram используют простой, быстрый и легкий метод, который, однако, существенно уступает по качеству новейшим поисковым системам.
И вот перед нами стоит цель, добиться наилучшего качества поиска, насколько это вообще возможно технически и физически чтоб он был и простым и качественным.
Первые шаги к улучшению
Самый простой способ улучшить текстовый поиск, это сохранять слова в базу данных без окончаний (этот процесс называется стеммингом). (конечно же будет 2 типа сохранения сам текст с окончаниями + текст разбитый на слова для поиска без окончаний)
К примеру, предложение:
«[люблю] [есть] [яблоки]»
После обработки превратится в набор основ:
«[любл] [ест] [яблок]»
Тогда при поиске по запросу «любила есть яблоко» (где формы слов другие) система всё равно найдет этот текст, так как основы слов совпадут.
Но у такого способа тоже есть две серьезные проблемы:
1. Склеивание абсолютно разных по смыслу слов. Стеммер работает «вслепую» и просто отрезает окончания. Из-за этого слова с разным смыслом, но похожими буквами, превращаются в одну основу. Например, слово «лечу» (от лететь) и «лечу» (от лечить) превратятся в одинаковую основу «леч». В итоге по запросу «как лечить простуду» поиск выдаст пост о том, как кто-то летит в отпуск.
2. игнорирование синонимов. Стемминг работает исключительно с буквами, а не со смыслом. Если вы ищете «смартфон», а в полезном посте написано «мобильник» или «телефон», поиск этот пост пропустит. Для классического текстового поиска это абсолютно разные, никак не связанные слова, ведь основы у них не совпадают.
Поэтому нужно не просто пытаться как-то по-особому сохранять или индексировать посты. Нужно искать именно смысловой метч.
Семантика поможет
Семантика - это смысл слов, фраз и предложений. Не то, как они написаны буквами, а то, что именно они означают. В контексте поиска, лингвистики и программирования семантика отвечает на простой вопрос: «Что именно имеется в виду?»
Так вот, нам нужно сделать поиск именно по семантике, а не по конкретным словам.
Как это работает? На вход ИИ-модель получает текст. Она анализирует его суть и делает из него своего рода «концентрат смысла». На выходе модель выдает вектор (массив чисел). Чем больше размерность этого вектора (количество чисел в массиве), тем точнее модель передает тонкие оттенки смысла и тем качественнее в итоге будет работать поиск.
Если по-простому, то вектор это как бы положение в многомерном пространстве. Если в векторе всего 3 числа, то его можно отобразить не теоретически, а на практике.
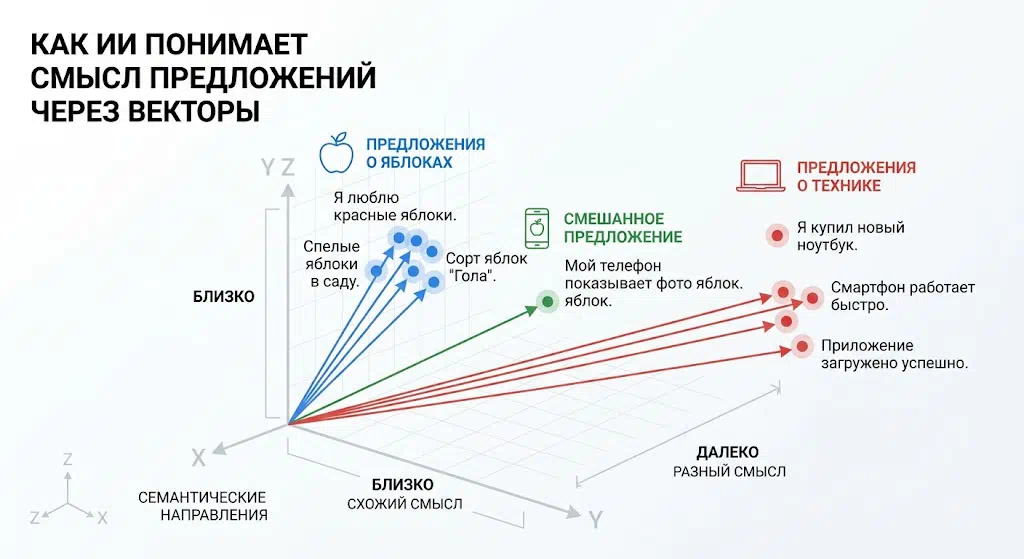
На картинке видно, что предложения про яблоки будут ближе друг к другу, чем предложения про телефон или технику. А вот что-то среднее будет посередине. Только если в 3D у нас всего 3 измерения, то у векторов может быть до 8 тысяч измерений (на самом деле бесконечно но обычно до 8 тысяч), чтобы передавать максимум смысла.
Правда, у такого поиска есть снова минус: он требует долгой индексации, так как абсолютно все текста постов должны пройти через ИИ-модель.
Чтобы подобрать подходящую модель, существуют специальные таблицы-бенчмарки (например MTEB). В основном эмбеддинг-модели отличаются следующими характеристиками:
Про сам процесс сбора данных я подробно рассказывать не буду. Напомню лишь, что собирать информацию можно только из открытых
каналов, так как парсить приватные чаты запрещает политика Telegram.
Итак, собрав посты из каналов и прогнав их через embedding-модель, мы наконец-то получаем систему, выдающую результаты, которые действительно похожи на качественный поиск.
Пример, поисковый запрос: «игра визуальная новелла скачать»
Вот как выглядит выдача обычного векторного поиска. Результаты семантически близки к теме визуальных новелл, но среди первых позиций много новостного шума и посторонних обсуждений, а не прямых ссылок на скачивание:
Результаты векторного поиска получились неплохими: модель поняла общую тему визуальных новелл. Однако выдача всё ещё забита околотематическим шумом, который напрямую не отвечает на запрос пользователя: "скачать игру". Нам нужно переранжировать результаты так, чтобы на первой позиции оказался пост, максимально точно отвечающий на запрос пользователя.
Конечно, можно было бы отправлять все найденные посты в ChatGPT и просить его отсортировать их по релевантности. Это дало бы самое лучшее качество, но обошлось бы очень дорого и заняло слишком много времени.
Для решения этой задачи существуют специальные, гораздо более быстрые модели которые были специально созданы для таких задач > реранкеры (Rerankers).
Как устроен двухэтапный поиск с реранкером
1. Этап 1: Быстрый отбор (Retrieval). Сначала векторный поиск находит широкий круг кандидатов (например, топ-50 или топ-100 постов) из базы данных.
2. Этап 2: Точечная переоценка (Reranking). Реранкер берёт запрос пользователя и каждый документ-кандидат и оценивает степень их соответствия. Модель выдаёт точную оценку релевантности (условно от 0% до 100%).
Чем выше этот процент, тем полезнее пост для пользователя. Нам остаётся лишь отсортировать кандидатов по убыванию этой оценки.
С реранкером:
А вот результаты после обработки моделью-реранкером. Он сопоставил истинный смысл запроса «скачать» и вывел на первые места посты, которые действительно содержат ссылки на скачивание и раздачи игр:
Отличные результаты!!!
какой итоговый пайплайн нашего MVP
Как ещё можно улучшить поиск?
Добавлять значимость к документу в зависимости в каком канале опубликован (какое количество подписчиков просмотров комментариев и реакций) но это не всегда правильно работает. Ну и ещё методы разного сочетания методов поиска и сортировки.
И так тестируем итоговый поиск на 3 сложных запросов
1 - “книга о компьютерных сетях скачать”.
Компьютерные сети - принципы, технологии, протоколы
Книга предназначена для людей, что хотели бы получить базовые знания о принципах построения компьютерных сетей, понять особенности традиционных и перспективных технологий локальных и глобальных сетей, изучить способы создания крупных составных сетей и управления такими сетями.
Скачать книгу
2 - “лучший ресторан Москвы где подают крабов“
Wine&Crab
Народный рейтинг: (4,9)
Ресторан с изобилием морских даров, расположенный в самом сердце Москвы.
В меню представлены разные виды крабов и других деликатесов из морепродуктов, а вина занимают целую комнату — их здесь более 900 позиций.
Средний чек: ~ 2 600 руб.
Кухня: рыба и морепродукты
Адрес: ул. Никольская 19-21к1 (на карте)
3 - “Лучший форум и маркет“
Самый популярный форум соц инженерии Есть маркет с различными товарами и услугами. Можно просто зависнуть на форуме и узнать для себя очень много полезной инфы
https://lolz.live/
(Это реальный результат из канала - Биржи бирж, от 31.08.2025)
Теперь мы можем строить запрос так, как мы именно хотим, не думая о том чтобы система точно правильно нас поняла.
и наконец я могу написать просто - Скачать беслпатно прошивку коммутатора
и мой поисковик отдаст мне -
Прошивка на Huawei S3928P-EI
https://.../index.php?/topic/153306-pr....
Итог
Изначальная цель моего проекта было создание поисковика по Telegram, который был бы качественным и интуитивно понятным, чтобы пользователь мог найти что угодно, не задумываясь над формулировкой запроса. И мне это удалось на все сто процентов. Сейчас я продолжаю работать над тем, чтобы поиск стал по-настоящему умным, учитывал тончайшие детали и корректно обрабатывал сложные технические запросы.
Чтобы не перегружать вас лишними подробностями, я не стал рассказывать о многочисленных мелких оптимизациях, архитектурных тонкостях и прочих деталях. Если вам это интересно пишите в лс на форуме или в Telegram.
Надеюсь вам было интересно. Первая статья у меня такого рода.
PS
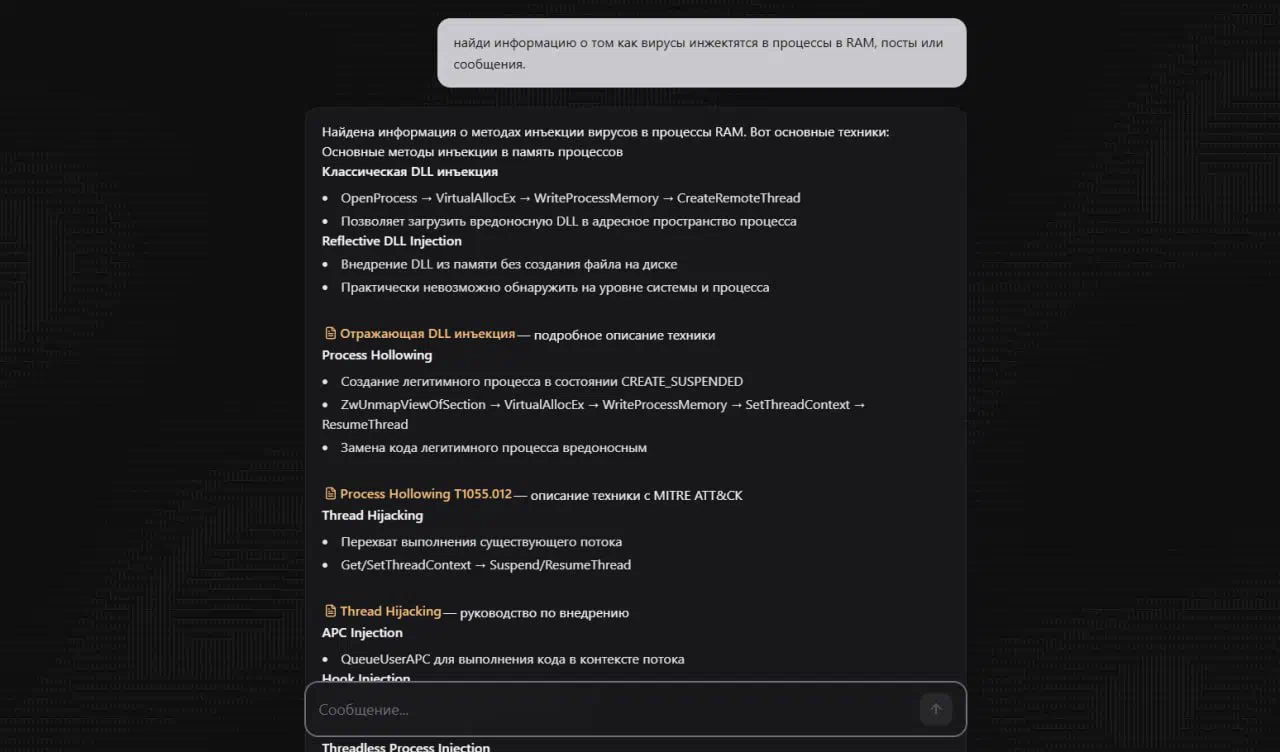
Спустя некоторое время я даже интегрировал поиск в ИИ-агента, чтобы тот мог самостоятельно извлекать данные и проводить полноценные исследования. И это стало просто невообразимо удобно
Мои личные поиски часто касается сферы информационной безопасности. Проблема в том, что в обычном интернете таких данных крайне мало. Например, я регулярно занимаюсь поиском прошивок для коммутаторов и роутеров для виртуализации сетей. в открытом доступе их практически нет, однако внутри Telegram среди энтузиастов они активно циркулируют.
Сегодня я расскажу как что я делал и смог ли вообще добиться своих целей спустя 2 года
Первоначальная задумка
Наверняка у многих бывают случаи, когда вы хотите что-то найти, но обычный Яндекс или Гугл не подходят для этого. Какие-нибудь рекомендации, новости, информацию которая в основном бывает только в телеграм (не запрещенная конечно, такое осуждаю). Нужно как то организовать все эти миллиарды постов с каналов на десятки терабайт чтобы сделать по ним удобный поиск.
Сначала всё кажется простым: создаешь базу Postgres и делаешь по ней поиск. Он ищет просто слова из запроса в постах. Если они есть и находятся близко друг к другу, то пост появляется в результатах.
Более продвинутая версия такого типа поиска использует алгоритм BM25 (алгоритм ранжирования).
BM25 (Best Match 25), это популярный алгоритм, который используют для оценки того, насколько точно найденный документ (в нашем случае пост) соответствует запросу пользователя. Он смотрит не только на то, есть ли нужные слова в документе, но и на то, насколько они там действительно важны. То есть он решает простую проблему: чтобы в результатах выше оказывались не самые длинные тексты и не те, где одно и то же слово просто напихано много раз, а те, где ответ на запрос реально ближе и полезнее.
Да, так можно сделать. Так устроен поиск и в Telegram, и в Lolz, да и почти везде. Это легко, быстро и надежно.
Но тут есть 2 проблемы.
1. Поиск не понимает контекст. Он не понимает, что кран, из которого течет вода, и кран, который поднимает грузы это разные вещи. Поэтому в результатах (особенно при абстрактных запросах) может получиться салат из постов, которые вообще не имеют отношения к тому что мы хотим найти.
2. Составление запросов становится адом. К примеру, я хочу найти, где скачать какую-нибудь старую игру-новеллу. Обычный пользователь привык писать в поиске: *«скачать новеллу ... бесплатно»*. Для обычных поисковиков вроде Яндекса и Google это нормальный запрос, но для нашего текущего поиска он не подходит. Если в тексте поста не окажется слов «бесплатно», «скачать» или «игра», то пост просто отбракуется и не попадет в результаты. Но если не писать «бесплатно», в выдачу полезут каналы, где игру предлагают купить.
В итоге сейчас большинство поисковиков по Telegram используют простой, быстрый и легкий метод, который, однако, существенно уступает по качеству новейшим поисковым системам.
И вот перед нами стоит цель, добиться наилучшего качества поиска, насколько это вообще возможно технически и физически чтоб он был и простым и качественным.
Первые шаги к улучшению
Самый простой способ улучшить текстовый поиск, это сохранять слова в базу данных без окончаний (этот процесс называется стеммингом). (конечно же будет 2 типа сохранения сам текст с окончаниями + текст разбитый на слова для поиска без окончаний)
К примеру, предложение:
«[люблю] [есть] [яблоки]»
После обработки превратится в набор основ:
«[любл] [ест] [яблок]»
Тогда при поиске по запросу «любила есть яблоко» (где формы слов другие) система всё равно найдет этот текст, так как основы слов совпадут.
Но у такого способа тоже есть две серьезные проблемы:
1. Склеивание абсолютно разных по смыслу слов. Стеммер работает «вслепую» и просто отрезает окончания. Из-за этого слова с разным смыслом, но похожими буквами, превращаются в одну основу. Например, слово «лечу» (от лететь) и «лечу» (от лечить) превратятся в одинаковую основу «леч». В итоге по запросу «как лечить простуду» поиск выдаст пост о том, как кто-то летит в отпуск.
2. игнорирование синонимов. Стемминг работает исключительно с буквами, а не со смыслом. Если вы ищете «смартфон», а в полезном посте написано «мобильник» или «телефон», поиск этот пост пропустит. Для классического текстового поиска это абсолютно разные, никак не связанные слова, ведь основы у них не совпадают.
Поэтому нужно не просто пытаться как-то по-особому сохранять или индексировать посты. Нужно искать именно смысловой метч.
Семантика поможет
Семантика - это смысл слов, фраз и предложений. Не то, как они написаны буквами, а то, что именно они означают. В контексте поиска, лингвистики и программирования семантика отвечает на простой вопрос: «Что именно имеется в виду?»
Так вот, нам нужно сделать поиск именно по семантике, а не по конкретным словам.
Как это работает? На вход ИИ-модель получает текст. Она анализирует его суть и делает из него своего рода «концентрат смысла». На выходе модель выдает вектор (массив чисел). Чем больше размерность этого вектора (количество чисел в массиве), тем точнее модель передает тонкие оттенки смысла и тем качественнее в итоге будет работать поиск.
Если по-простому, то вектор это как бы положение в многомерном пространстве. Если в векторе всего 3 числа, то его можно отобразить не теоретически, а на практике.
На картинке видно, что предложения про яблоки будут ближе друг к другу, чем предложения про телефон или технику. А вот что-то среднее будет посередине. Только если в 3D у нас всего 3 измерения, то у векторов может быть до 8 тысяч измерений (на самом деле бесконечно но обычно до 8 тысяч), чтобы передавать максимум смысла.
Правда, у такого поиска есть снова минус: он требует долгой индексации, так как абсолютно все текста постов должны пройти через ИИ-модель.
Чтобы подобрать подходящую модель, существуют специальные таблицы-бенчмарки (например MTEB). В основном эмбеддинг-модели отличаются следующими характеристиками:
- Количество параметров. Чем больше параметров у модели, тем глубже и точнее она понимает смысл текста, но тем медленнее она работает и тем больше ресурсов требует.
- Направленность и языки. Некоторые модели заточены только под английский язык, другие — мультиязычные (поддерживают и русский или только русский), а некоторые вообще специализируются на узких задачах (например, поиск по кодовой базе).
- Показатель Zero-shot. Насколько хорошо модель «интуитивно» понимает новые или редкие слова, которых не было в её обучающих материалах.
Про сам процесс сбора данных я подробно рассказывать не буду. Напомню лишь, что собирать информацию можно только из открытых
каналов, так как парсить приватные чаты запрещает политика Telegram.
Итак, собрав посты из каналов и прогнав их через embedding-модель, мы наконец-то получаем систему, выдающую результаты, которые действительно похожи на качественный поиск.
Пример, поисковый запрос: «игра визуальная новелла скачать»
Вот как выглядит выдача обычного векторного поиска. Результаты семантически близки к теме визуальных новелл, но среди первых позиций много новостного шума и посторонних обсуждений, а не прямых ссылок на скачивание:
- В Steam вышла «бесконечная» визуальная новелла от российского разработчика...
В ней история и визуальные эффекты динамически создаются с помощью ИИ. Кроме того... - Найди игру в стиле визуальной новеллы, где принцессе, будущей наследнице...
...нужно развивать её навыки и идти по сюжету, сюжет зависит от выборов игрока в сторону тех или иных навыков... - Лучшие движки для визуальных новелл
Разбираем плюсы и минусы самых популярных и доступных движков, на которых можно сделать собственную игру в модном жанре…
Результаты векторного поиска получились неплохими: модель поняла общую тему визуальных новелл. Однако выдача всё ещё забита околотематическим шумом, который напрямую не отвечает на запрос пользователя: "скачать игру". Нам нужно переранжировать результаты так, чтобы на первой позиции оказался пост, максимально точно отвечающий на запрос пользователя.
Конечно, можно было бы отправлять все найденные посты в ChatGPT и просить его отсортировать их по релевантности. Это дало бы самое лучшее качество, но обошлось бы очень дорого и заняло слишком много времени.
Для решения этой задачи существуют специальные, гораздо более быстрые модели которые были специально созданы для таких задач > реранкеры (Rerankers).
Как устроен двухэтапный поиск с реранкером
1. Этап 1: Быстрый отбор (Retrieval). Сначала векторный поиск находит широкий круг кандидатов (например, топ-50 или топ-100 постов) из базы данных.
2. Этап 2: Точечная переоценка (Reranking). Реранкер берёт запрос пользователя и каждый документ-кандидат и оценивает степень их соответствия. Модель выдаёт точную оценку релевантности (условно от 0% до 100%).
Чем выше этот процент, тем полезнее пост для пользователя. Нам остаётся лишь отсортировать кандидатов по убыванию этой оценки.
С реранкером:
А вот результаты после обработки моделью-реранкером. Он сопоставил истинный смысл запроса «скачать» и вывел на первые места посты, которые действительно содержат ссылки на скачивание и раздачи игр:
- СКАЧАТЬ НОВЕЛЛЫ БЕЗ СМС И РЕГИСТРАЦИИ
На нашем канале вы можете бесплатно скачать визуальные и RPG-новеллы. Все они переведены на русский язык... - Вышел официальный русский перевод визуальной новеллы "LOVELETTER".
Скачать бесплатно на VK Play. Особенности: прохождение 4 часа, 8 уникальных концовок, 18 CG... - Халява! Визуальная новелла на 20 минут
Просто переходите по ссылке, кликаете на нужную кнопку и скачиваете установочные файлы...
Отличные результаты!!!
какой итоговый пайплайн нашего MVP
- Сначала векторный поиск находит 100 результатов
- Эти 100 результатов попадают в реранкер и он их сортирует. В конечном итоге в результатах остается только 10 документов, которые лучше всего отвечают нашему запросу.
Как ещё можно улучшить поиск?
Добавлять значимость к документу в зависимости в каком канале опубликован (какое количество подписчиков просмотров комментариев и реакций) но это не всегда правильно работает. Ну и ещё методы разного сочетания методов поиска и сортировки.
И так тестируем итоговый поиск на 3 сложных запросов
1 - “книга о компьютерных сетях скачать”.
Компьютерные сети - принципы, технологии, протоколы
Книга предназначена для людей, что хотели бы получить базовые знания о принципах построения компьютерных сетей, понять особенности традиционных и перспективных технологий локальных и глобальных сетей, изучить способы создания крупных составных сетей и управления такими сетями.
Скачать книгу
2 - “лучший ресторан Москвы где подают крабов“
Wine&Crab
Народный рейтинг: (4,9)
Ресторан с изобилием морских даров, расположенный в самом сердце Москвы.
В меню представлены разные виды крабов и других деликатесов из морепродуктов, а вина занимают целую комнату — их здесь более 900 позиций.
Средний чек: ~ 2 600 руб.
Кухня: рыба и морепродукты
Адрес: ул. Никольская 19-21к1 (на карте)
3 - “Лучший форум и маркет“
Самый популярный форум соц инженерии Есть маркет с различными товарами и услугами. Можно просто зависнуть на форуме и узнать для себя очень много полезной инфы
https://lolz.live/
(Это реальный результат из канала - Биржи бирж, от 31.08.2025)
Теперь мы можем строить запрос так, как мы именно хотим, не думая о том чтобы система точно правильно нас поняла.
и наконец я могу написать просто - Скачать беслпатно прошивку коммутатора
и мой поисковик отдаст мне -
Прошивка на Huawei S3928P-EI
https://.../index.php?/topic/153306-pr....
Итог
Изначальная цель моего проекта было создание поисковика по Telegram, который был бы качественным и интуитивно понятным, чтобы пользователь мог найти что угодно, не задумываясь над формулировкой запроса. И мне это удалось на все сто процентов. Сейчас я продолжаю работать над тем, чтобы поиск стал по-настоящему умным, учитывал тончайшие детали и корректно обрабатывал сложные технические запросы.
Чтобы не перегружать вас лишними подробностями, я не стал рассказывать о многочисленных мелких оптимизациях, архитектурных тонкостях и прочих деталях. Если вам это интересно пишите в лс на форуме или в Telegram.
Надеюсь вам было интересно. Первая статья у меня такого рода.
PS
Спустя некоторое время я даже интегрировал поиск в ИИ-агента, чтобы тот мог самостоятельно извлекать данные и проводить полноценные исследования. И это стало просто невообразимо удобно
Комментарии 0